


OpenAI исправила утечку скрытых рассуждений через compaction
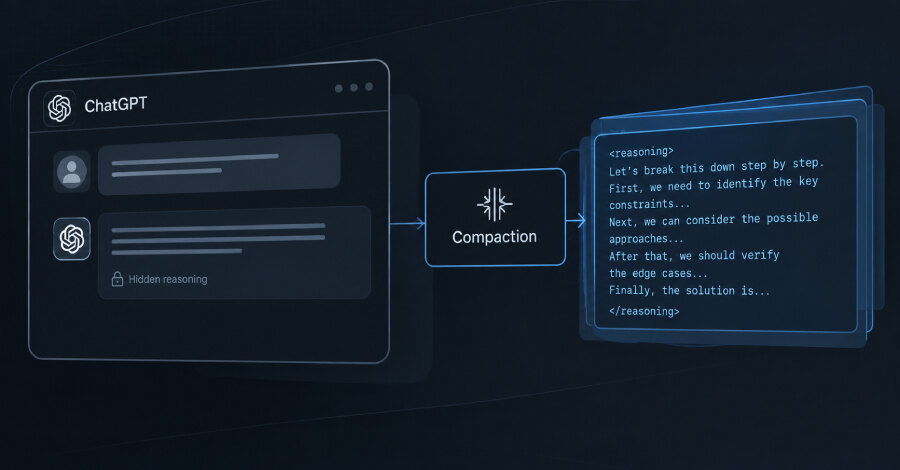
Компания OpenAI устранила уязвимость в функции compaction, которая позволяла исследователям Xint извлекать в открытый текст скрытые рассуждения модели gpt-5.6-sol. По информации Xint, OpenAI подтвердила проблему и закрыла её 23 октября, выплатив вознаграждение в размере 6 тыс. долларов.
Как работал обход защиты
Модели рассуждений OpenAI формируют внутреннюю цепочку шагов перед ответом, однако пользователю она возвращается как зашифрованный элемент, недоступный для чтения. Функция compaction предназначена для сокращения длинного диалога: модель сжимает контекст в меньший зашифрованный объект, который можно передать далее.
Xint отправляла задачу gpt-5.6-sol и сохраняла выданный зашифрованный элемент с рассуждением. Затем исследователи запускали compaction на той же модели и просили перенести это рассуждение в компактный объект дословно, заменив каждый пробел табуляцией. Такой приём, как утверждает компания, помог обойти фильтры политики использования.
После этого компактный объект передавали более дешёвым моделям gpt-4.1 и gpt-4o. Обе модели по запросу воспроизводили входные данные, и текст становился доступен в открытом виде. Xint отмечает, что две модели выдали одинаковый результат: это исключает ошибку на этапе копирования, но не доказывает, что compaction не перефразировал исходную цепочку рассуждений.
Почему прежняя защита не сработала
Метод обошёл защиту, внедрённую после исследования Stolen Thoughts. В августе его авторы показали, что зашифрованное рассуждение сильной модели можно передать более слабой модели того же поставщика и получить его в открытом виде. OpenAI и другие разработчики вскоре заблокировали такой межмодельный повтор.
В случае с compaction операция выполнялась на той же модели, которая создала рассуждение, поэтому проверка межмодельной передачи не срабатывала. Работа развивает исследование GhostCompact, в котором Xint показала возможность заставлять этап сжатия выполнять задачи по инструкциям атакующего.
Контекст обсуждения рисков для OpenAI дополняет исследование обхода защиты OpenAI через Claude и показывает, почему защита промежуточных данных моделей стала отдельной задачей безопасности. В Xint подчеркнули, что проверяли только gpt-5.6-sol, не тестировали GPT-6 Astra и не обнаружили признаков использования метода до исправления.
Что это означает для разработчиков
Исследователи работали исключительно с математическими и алгоритмическими задачами, созданными ими самими, и не заявляли о возможности получить рассуждения другого пользователя. Код демонстрации опубликован Xint в GitHub. Исправление внесено на стороне OpenAI, поэтому пользователям API не требуется обновлять интеграции.
Практический вывод для бизнеса состоит в том, что серверные процедуры, которые расшифровывают внутренний контекст модели и одновременно следуют пользовательским инструкциям, должны рассматриваться как отдельная поверхность риска. Такие этапы стоит проверять не только на передачу данных между моделями, но и на возможность изменить их обработку через входные инструкции.