


Решающие ИИ-модели обещают дешёвый триаж SOC, но требуют контекста
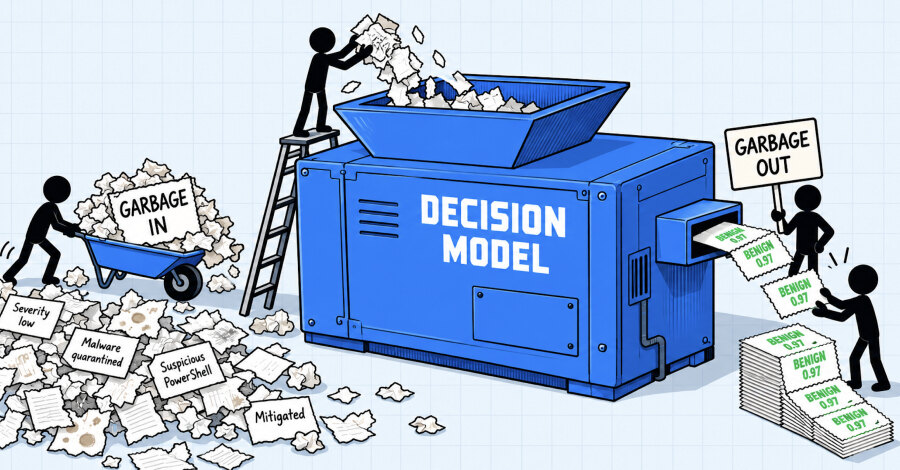
Решающие ИИ-модели, включая Jev от TypeSafe AI, Decisions API от OpenAI и адаптер cribl-decision от Cribl, предлагают SOC не сгенерированный текст, а фиксированный выбор, оценку или ответ «да/нет» с вероятностью. TypeSafe AI заявляет для Jev задержку от 70 до 500 мс и цену $42 за миллиард входных токенов, что меняет экономику проверки потока алертов.
Подобные модели можно подключать к правилам автоматизации. Например, алерт с оценкой «безопасно» выше 0,97 можно закрыть, событие ниже 0,6 — эскалировать как вероятный инцидент, а промежуточные случаи направить аналитику. Для необратимых действий пороги должны быть строже, чем для добавления комментария в тикет.
Форматированный ответ не равен верному решению
Преимущество класса моделей — проверяемость. Пространство ответов задано заранее, а вероятность можно записать, воспроизвести решение и сопоставить его с фактическим исходом. Это проще аудировать, чем свободное текстовое объяснение.
Однако отсутствие выхода за пределы схемы не означает отсутствия ошибок. Калибровка в 90% означает лишь, что на похожих входных данных модель в среднем оказывается права примерно в девяти случаях из десяти. Если ей передали только заголовок алерта и уровень важности, она не знает состояния хоста, процессов в памяти и реального контекста пользователя.
Почему метаданных алерта недостаточно
В отчёте AI SOC Report 2026, основанном на 25 млн алертов за 2025 год, указано, что 82 тыс. событий сопровождались сканированием памяти конечной точки. Активная инфекция обнаружилась примерно на 2,6 тыс. машин, причём 51% этих устройств EDR уже пометил как устранённые.
Такой алерт может выглядеть безобидно: вредоносное ПО найдено, угроза помещена в карантин, низкий приоритет. Модель вправе уверенно закрыть его, если большинство похожих событий действительно безопасны. Ошибка находится не в форме ответа, а в неполных исходных данных.
Уровень критичности также нельзя превращать в единственный фильтр. Авторы сообщают, что почти 1% подтверждённых инцидентов был связан с алертами самого низкого уровня. При среднем потоке в 450 тыс. алертов в год это примерно 54 реальные угрозы, или около одной в неделю.
Что должно предшествовать автоматическому вердикту
Для расследования нужны факты: дерево процессов, родительский процесс, полная командная строка, содержимое скрипта, результаты запуска файла в песочнице, сетевые обращения и проверка памяти. Последнее особенно важно для Mimikatz, Meterpreter и Cobalt Strike: эти инструменты могут работать в памяти, где статус файлового карантина их не отражает.
Не менее важен организационный контекст. В данных авторов 74% алертов идентификации были отнесены к вероятно безопасным, а подтверждёнными компрометациями оказались около 2% событий impossible travel. Только использование VPN давало около 30% таких сигналов. Модель не сможет сама понять, что вход пользователя из другой страны привычен, а оповещение на сервере сборки регулярно возникает во время релиза.
Бизнесу стоит использовать решающие модели как последний, дешёвый и аудируемый этап триажа, а не как замену расследованию. Инвестиции нужны в непрерывный сбор технических доказательств, актуализацию сведений об активах и нормальном поведении, а также в сверку автоматических вердиктов с итогами инцидентов. Именно качество этого контекста определяет, можно ли доверять вероятности модели в конкретной среде.