


Modeli za odluke menjaju automatizaciju trijaže u SOC-u
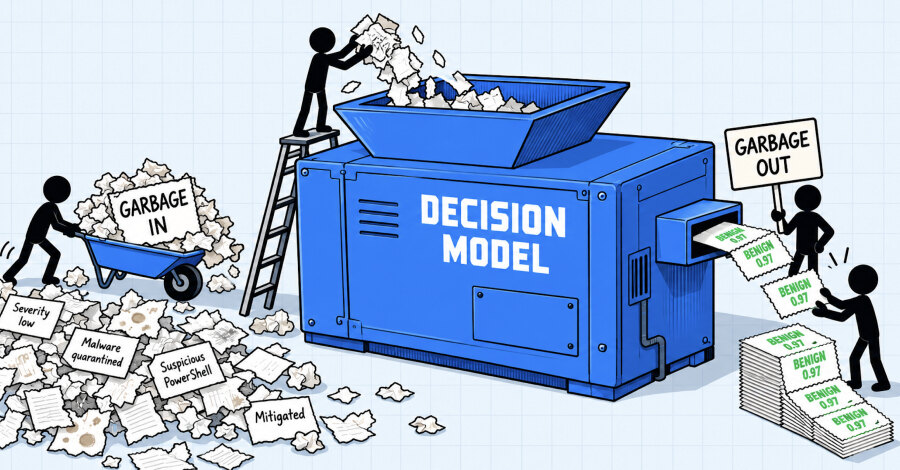
Modeli veštačke inteligencije za donošenje odluka, među kojima su TypeSafe AI Jev, OpenAI Decisions API, Cribl-ov cribl-decision i alati poput Laya, vraćaju strukturisan izbor, rezultat ili odgovor da/ne sa verovatnoćom umesto generisanog teksta. Za bezbednosno-operativne centre to otvara mogućnost automatizovane trijaže upozorenja uz unapred određene pragove: zatvaranje benignih nalaza, eskalaciju verovatnih incidenata i upućivanje nejasnih slučajeva analitičaru.
TypeSafe AI za Jev navodi odziv od 70 do 500 milisekundi i cenu od 42 dolara po milijardi ulaznih tokena. Primer sa 450.000 upozorenja godišnje i nekoliko hiljada tokena po upozorenju pokazuje da trošak odluke može biti oko stotinu dolara godišnje. Zato ekonomski razlog da se analiziraju samo upozorenja visokog prioriteta postaje znatno slabiji.
Strukturisan odgovor nije dokaz tačnosti
Fiksiran format odgovora olakšava beleženje, ponavljanje i poređenje odluke sa stvarnim ishodom. Međutim, tvrdnja da model ne halucinira odnosi se na usklađenost sa šemom izlaza, a ne na istinitost zaključka. Model može uredno vratiti pogrešan odgovor ako su podaci na kojima zasniva odluku nepotpuni ili pogrešno predstavljeni.
Kalibrisana verovatnoća opisuje ponašanje na skupu ulaza koji liče na postojeći slučaj. Ako model dobije samo naziv upozorenja i nivo ozbiljnosti, njegova procena ne uključuje stanje uređaja, tok procesa ili stvarni trag napada. Zato odluka o automatizaciji ne može počivati samo na metapodacima upozorenja.
Forenzički dokazi menjaju kvalitet trijaže
Izveštaj AI SOC Report 2026 obuhvata 25 miliona upozorenja obrađenih tokom 2025. godine. Među 82.000 upozorenja za koja je pokrenuto skeniranje radne memorije, oko 2.600 uređaja imalo je aktivnu infekciju. Čak 51% tih zaraženih uređaja EDR je već označio kao sanirane. U podacima se gotovo 1% stvarnih incidenata vezuje za upozorenja najnižih nivoa ozbiljnosti, što pri proseku od 450.000 upozorenja godišnje predstavlja približno 54 stvarne pretnje.
Potpunija istraga zato uključuje stablo procesa, nadređeni proces, punu komandnu liniju i skripte na disku, ali i ponašanje datoteke u sandboxu, mrežne veze i sadržaj memorije. Alati kao što su Mimikatz, Meterpreter i Cobalt Strike često deluju u memoriji, gde status karantina zasnovan na datoteci ne mora da otkrije aktivan kod ili bezdatotečni teret.
Organizacioni kontekst mora da se obnavlja
Forenzički dokaz govori šta se dogodilo na uređaju, ali ne i da li je ponašanje očekivano u konkretnoj organizaciji. U podacima za 2025. godinu 74% upozorenja vezanih za identitet ocenjeno je kao verovatno benigno, dok su upozorenja o nemogućem putovanju potvrđena kao stvarni kompromisi u oko 2% slučajeva. Sam VPN je izazivao oko 30% takvih upozorenja.
Zato znanje o korisnicima, uređajima, uobičajenom radu timova i strukturi SIEM podataka ne sme ostati samo u iskustvu pojedinaca. Potrebno ga je učiti iz prethodnih slučajeva, dopunjavati živim kontekstom tokom istrage i nakon svakog ishoda proveravati da li je automatizovana procena bila opravdana. Poslovni zaključak je praktičan: modele za odluke treba postaviti na kraj procesa, nakon prikupljanja dokaza, a njihovu kalibraciju neprekidno meriti u sopstvenom okruženju.