


Google представила Gemini 4 Carbon для поиска и исправления уязвимостей
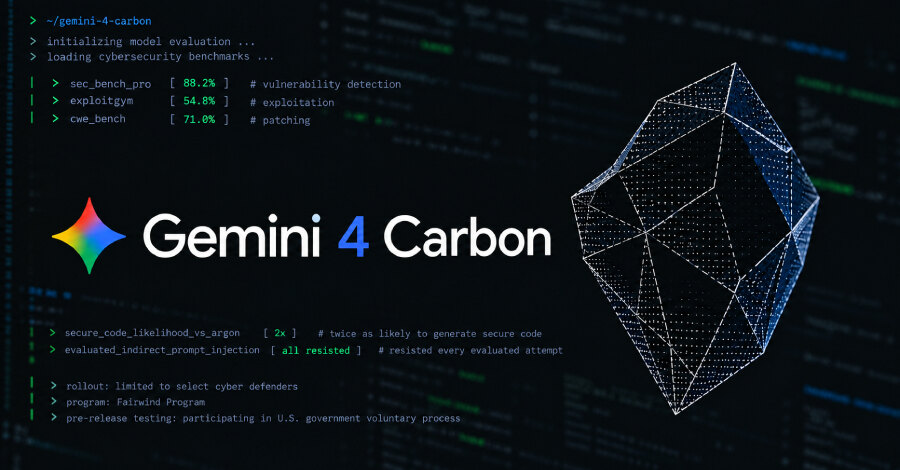
Google представила Gemini 4 Carbon — новую флагманскую модель с акцентом на кибербезопасность и длительные агентные задачи. По заявлению Google DeepMind, модель набрала 88,2% в SEC-bench Pro для поиска уязвимостей, 54,8% в ExploitGym для эксплуатации и 71,0% в CWE-bench для подготовки исправлений.
О запуске сообщил старший вице-президент Google DeepMind и главный архитектор ИИ Google Корай Кавукчуоглу. Компания также отметила улучшения в программировании и агентных задачах, которые важны для защиты ПО: выявлении, валидации и устранении уязвимостей.
Результаты тестов и безопасность модели
В индексе Artificial Analysis Intelligence Index Gemini 4 Carbon получила 59 баллов. В сообщении Google этот результат сопоставлен с 58 баллами Claude Opus 5.5, 57 баллами OpenAI GPT-6 Astra и 55 баллами GPT-6.1 Sol.
Google утверждает, что Carbon вдвое чаще создаёт безопасный код, чем Gemini 4 Argon. При сложных или срочных задачах с неоднозначными условиями модель должна запрашивать участие человека, а не выбирать путь на основе предположений. В испытаниях на непрямые prompt-инъекции Carbon отразила все проверенные попытки атак.
Доступ пока ограничен
Анонс Carbon состоялся менее чем через неделю после Gemini 4 Argon. На первом этапе Google предоставляет новую модель ограниченному кругу специалистов по киберзащите, затем намерена расширять доступ для доверенных партнёров в рамках программы Fairwind.
Компания также участвует в добровольном процессе предварительного тестирования моделей, организованном правительством США. Параллельно OpenAI выпустила GPT-6.1 Terra, а Anthropic рассказала о внутренней исследовательской модели, которая обнаружила критические уязвимости в Google Chrome, Apple Safari, Android и драйвере Windows HTTP.sys. Google, Apple и Microsoft сообщили об исправлении найденных проблем.
Что это означает для организаций
Показатели Gemini 4 Carbon демонстрируют, что модели всё активнее применяются на разных этапах работы с уязвимостями — от поиска до проверки и исправления. При этом ограниченный запуск и заявленный акцент на участии человека подчёркивают необходимость сохранять экспертную проверку результатов, контролировать доступ к инструментам и не переносить критические решения по безопасности на модель без валидации.