


Hugging Face призвала стандартизировать оценку ИИ-систем
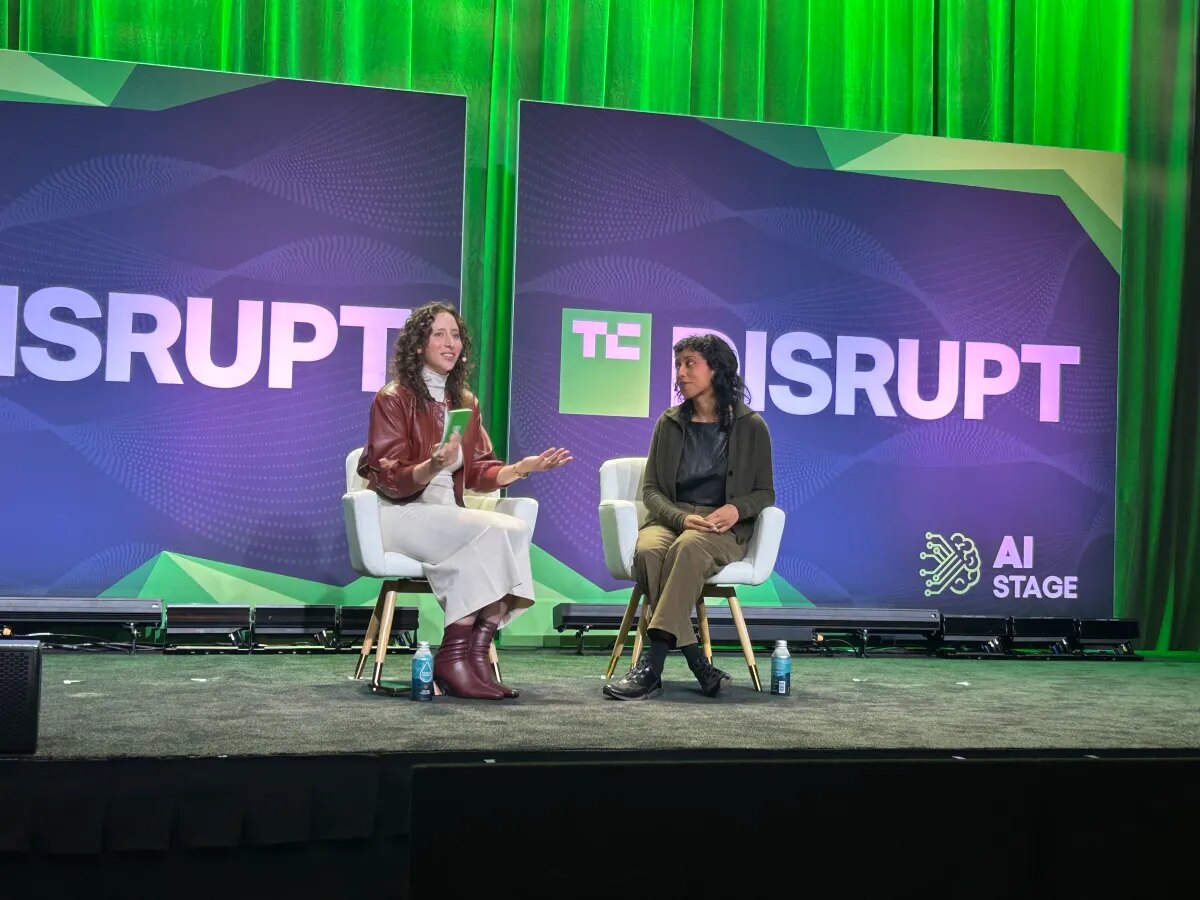
Hugging Face считает, что встроенные независимые оценщики не станут простым решением для контроля рисков ИИ. Директор по политике компании Ирен Солейман на TechCrunch Disrupt заявила: ключевые проблемы связаны с воспроизводимостью результатов, сопоставлением разных тестов и оценкой не только моделей, но и всей агентной системы вокруг них.
Почему бенчмарков недостаточно
Лаборатории ИИ активно используют бенчмарки, чтобы показывать качество своих моделей. Однако Солейман подчеркнула, что доверие к результату начинается с возможности его воспроизвести. Для этого необходим достаточный доступ к самой модели; существенную роль здесь могут играть открытые веса.
Даже если отдельный тест валиден, остаётся вопрос о его месте среди других методик. По словам Солейман, оценка ИИ остаётся развивающейся областью: индустрия пока не умеет осмысленно сравнивать оценки между собой. Тесты сравнительно быстро теряют эффективность, а экосистема проверок развита недостаточно.
Спрос на внешних оценщиков растёт
Идея встроенных оценщиков предполагает, что внешние наблюдатели будут работать внутри ИИ-компаний и оценивать безопасность их технологий. Этот подход стал заметнее на фоне серии инцидентов, которые усилили опасения по поводу возможного вреда от ИИ. Сами лаборатории продвигают стороннюю проверку как альтернативу активному государственному регулированию.
Но независимость и компетентность таких проверяющих остаются предметом дискуссии. Решение Anthropic привлечь Accenture первым оценщиком вызвало критику: часть наблюдателей усомнилась, что консалтинговая компания подходит для этой роли. Солейман отметила, что для экосистемы встроенных оценщиков требуется гораздо больше стандартизации — в том числе критериев, определяющих квалификацию оценщика для конкретных задач.
Оценивать нужно всю систему
Проверка постепенно выходит за пределы самой модели. Важны также агент и обвязка, через которую пользователь получает доступ к модели. Солейман указала, что более слабая модель с лучшей обвязкой способна превзойти передовую модель, если сравнивать итоговую работу системы.
Оценки агентных систем сложны и дороги. Для моделей уже существует больше тестов, чем для обвязок, хотя именно комплексные агенты всё чаще приносят пользователям практическую ценность. Поэтому методики для целостной оценки агентов ещё формируются.
Для бизнеса это означает, что результаты общих бенчмарков нельзя считать единственным критерием выбора. ИИ-продукт стоит проверять в собственных сценариях, вместе с используемыми инструментами, обвязкой и способом интеграции, а не оценивать только по месту модели в рейтинге.