


Hugging Face: standardi su ključni za evaluaciju AI sistema
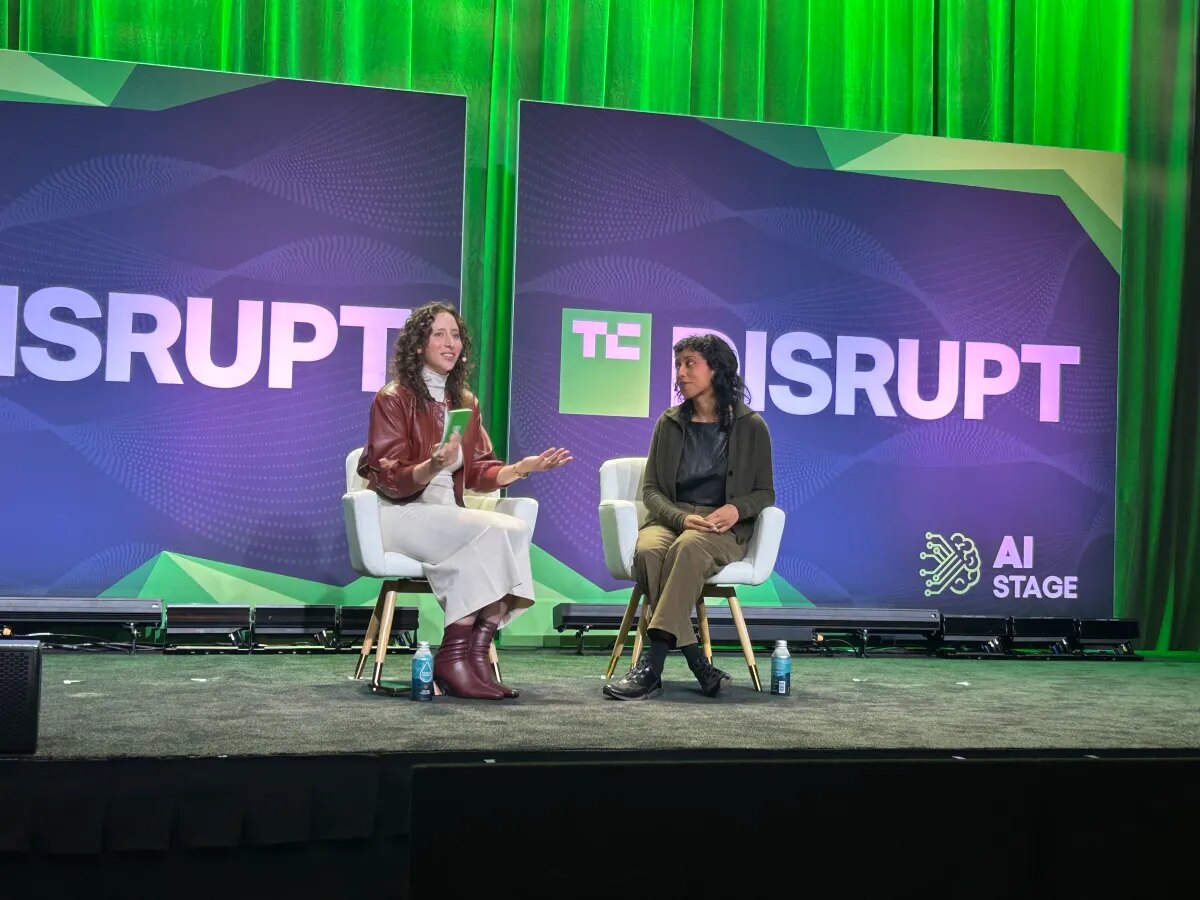
Irene Solaiman, direktorka za politiku u kompaniji Hugging Face, ocenila je na događaju TechCrunch Disrupt da ugrađeni nezavisni ocenjivači neće jednostavno rešiti pitanja bezbednosti AI sistema. Ona je istakla da se benchmark testovi, na koje AI laboratorije oslanjaju reputaciju svojih modela, još razvijaju i da su za pouzdane rezultate potrebni ponovljivost, pristup modelu i ujednačeniji standardi.
Ponovljivost je osnova poverenja
Testovi modela treba da omoguće proveru dobijenih rezultata. Solaiman je naglasila da je za to važno pitanje da li drugi mogu da reprodukuju evaluaciju i da li imaju potreban nivo pristupa samom modelu. U tom kontekstu posebno je pomenula otvorene težine modela, koje mogu olakšati pristup potreban za takvu proveru.
Problem nije ograničen na validnost pojedinačnog testa. Industrija još nema jasan način da smisleno poredi različite evaluacije međusobno. Kako se testovi razvijaju, mogu relativno brzo izgubiti delotvornost, a ekosistem evaluacija još nije dovoljno razvijen za potrebe industrije.
Ugrađeni ocenjivači traže jasne kvalifikacije
Ideja da neutralni posmatrači rade unutar AI organizacija dobila je pažnju posle niza incidenata koji su pojačali zabrinutost zbog mogućih šteta od ove tehnologije. Laboratorije su kao alternativu aktivnoj državnoj regulativi predlagale angažovanje trećih strana za prepoznavanje i ublažavanje bezbednosnih rizika.
Ipak, ostaju pitanja o neutralnosti i stvarnoj stručnosti takvih ocenjivača. Anthropic je za prvog ocenjivača angažovao Accenture, a ta odluka izazvala je kritike, uključujući sumnje da konsultantska kompanija ima potrebne kvalifikacije. Solaiman smatra da je za ekosistem ugrađenih ocenjivača potrebno znatno više standardizacije kriterijuma koji određuju ko može delotvorno da ocenjuje različite zadatke.
Od modela do celog agentnog sistema
Evaluacije se sada pomeraju sa samog modela na kompletan sistem koji ga okružuje, uključujući harness i agenta. Harness je alat kojim korisnik pristupa modelu i može značajno uticati na ostvarene performanse. Solaiman je navela da slabiji model sa boljim harnessom može nadmašiti napredni model.
Procene agentnih sistema su, prema njenim rečima, veoma teške i skupe. Za modele postoji više evaluacija nego za harness alate, dok se procene celovitih agenata tek unapređuju, iako upravo od njih mnogi korisnici dobijaju praktičnu vrednost.
Za poslovanje to znači da rezultat benchmarka ne treba posmatrati kao samostalnu potvrdu kvaliteta. Pri izboru AI rešenja potrebno je proveriti metod testiranja, mogućnost ponavljanja rezultata i okruženje u kojem model, harness i agent zajedno rade.